
Даже надёжный хостинг может перестать работать. Причиной бывают аппаратные аварии, ошибки обновлений, сетевые сбои, DDoS-атаки и компрометация инфраструктуры провайдера. В такие моменты бизнес может одновременно потерять доступ к сайту, корпоративной почте, базам данных и административным инструментам.
Полностью исключить подобные ситуации невозможно. Но можно подготовить инфраструктуру так, чтобы сбой одного поставщика не приводил к длительной остановке всего бизнеса.
Для этого недостаточно просто выбрать дорогой тариф или настроить ежедневное резервное копирование. Важно понимать, где хранятся данные, какие компоненты зависят друг от друга и как быстро сайт можно запустить на альтернативном сервере.
Разбираем семь способов защиты сайта от падения хостинга, их преимущества, ограничения и ситуации, в которых они действительно необходимы.
Хостинг — это не только сервер, на котором размещены файлы сайта. Работа современного веб-проекта может зависеть сразу от нескольких компонентов: DNS, базы данных, облачного хранилища, почты, внешних API и системы управления инфраструктурой.
Иногда достаточно отказа одного элемента, чтобы весь проект оказался недоступен.
Например, сайт может продолжать работать на сервере, но пользователи не смогут открыть его из-за проблем с DNS. В другом случае главная страница загружается, однако отправка заявок не работает из-за недоступности базы данных.
| Причина | Что происходит | Типичный результат |
|---|---|---|
| Сбой физического сервера | Оборудование перестаёт отвечать | Сайт недоступен |
| Проблемы DNS | Домен не разрешается в IP-адрес | Браузер не находит сайт |
| Ошибка веб-приложения | Программа перестаёт корректно работать | Ошибки 500 или 502 |
| Недоступность базы данных | Приложение не может получить информацию | Сбои форм, каталога и личного кабинета |
| DDoS-атака | Инфраструктура перегружена запросами | Медленная работа или недоступность |
| Кибератака на провайдера | Нарушается работа управляющих систем | Могут пострадать сразу несколько сервисов |
| Ошибка обновления | Новая версия приложения работает некорректно | Частичная или полная недоступность |
Для владельца бизнеса все эти ситуации часто выглядят одинаково: сайт не открывается. Однако методы восстановления могут существенно различаться.
Поэтому первый принцип отказоустойчивости — понимать, какие компоненты обеспечивают работу проекта и от чего зависит каждый из них.
Резервные копии — базовый элемент защиты информации. Если данные повреждены или удалены, бэкап позволяет восстановить их состояние на определённый момент времени.
Но здесь важно различать две задачи.
Резервное копирование защищает данные от потери. Отказоустойчивость помогает сохранять доступность сервиса при сбоях.
Наличие бэкапа не означает, что сайт автоматически продолжит работать после аварии.
Для полноценного восстановления сайта могут потребоваться:
Пароли и секретные ключи необходимо хранить отдельно, в защищённом хранилище с контролируемым доступом.
Например, если сайт разработан на Next.js и использует PostgreSQL, копия исходного кода в Git не гарантирует восстановление действующего проекта. Потребуется база данных и конфигурация окружения.
Представим, что сайт расположен на VPS, а его резервные копии сохраняются в облачное хранилище того же провайдера.
При обычной поломке виртуального сервера такой подход может оказаться достаточным. Но если проблема затронет всю облачную инфраструктуру, доступ к бэкапам также может быть потерян.
Более надёжная модель предполагает независимые места хранения.
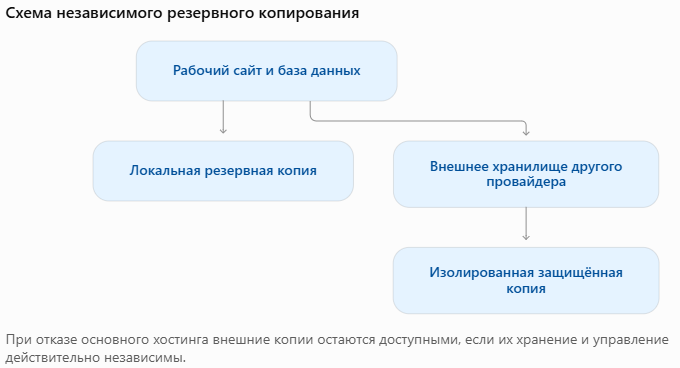
Полезно ориентироваться на принцип 3-2-1: несколько копий, разные носители или системы хранения и хотя бы одна копия за пределами основной инфраструктуры.
Для защиты от вредоносного удаления стоит рассмотреть неизменяемые резервные копии. Они позволяют ограничить изменение или удаление архивов в течение заданного срока.
При этом даже защищённый бэкап необходимо периодически проверять.
AWS Well-Architected рекомендует проводить тестовое восстановление и проверять, соответствует ли процедура установленным требованиям к допустимому времени простоя и потере данных.
Когда подходит: практически любому сайту, независимо от размера бизнеса.
Ограничение: восстановление из резервной копии требует времени и доступной инфраструктуры.
Один из наиболее эффективных способов снизить зависимость от конкретного хостинга — заранее подготовить альтернативное окружение.
Резервный сервер может находиться в другом дата-центре или у независимого поставщика.
Если основной сервер перестанет работать, сайт можно будет запустить на резервном.
Но уровень защиты зависит от того, насколько подготовлен этот сервер.
Резервная инфраструктура заранее не запущена или создана лишь частично.
При аварии специалист разворачивает сервер, восстанавливает данные и настраивает необходимые сервисы.
Преимущество — сравнительно низкие расходы на постоянное содержание.
Недостаток — восстановление может занять значительное время.
Часть инфраструктуры уже работает: установлен веб-сервер, подготовлено приложение, настроены необходимые зависимости.
Данные регулярно синхронизируются или восстанавливаются из резервного хранилища.
При аварии остаётся выполнить ограниченное количество действий.
Такой подход требует дополнительных затрат, но может значительно сократить время восстановления.
Резервная инфраструктура поддерживается в состоянии готовности к приёму трафика.
При корректно настроенной синхронизации данных и переключении запросов время простоя может быть минимальным.
Но это более сложное и дорогостоящее решение. Особенно если сайт постоянно обрабатывает заказы, платежи или другие изменяющиеся данные.
| Решение | Постоянные затраты | Скорость восстановления | Сложность |
|---|---|---|---|
| Холодный резерв | Низкие | Низкая | Невысокая |
| Тёплый резерв | Средние | Средняя или высокая | Средняя |
| Горячий резерв | Высокие | Потенциально очень высокая | Высокая |
Это относительная оценка. Реальное время восстановления зависит от архитектуры сайта, объёма данных и проведённых испытаний.
Такие стратегии также выделяются в руководстве AWS Well-Architected по аварийному восстановлению.
Когда подходит: интернет-магазинам, B2B-платформам, корпоративным сервисам и сайтам, для которых длительный простой связан с ощутимыми потерями.
DNS сопоставляет доменное имя с IP-адресом сервера.
Когда пользователь вводит адрес сайта, браузеру необходимо определить, куда отправить запрос.
Если DNS-инфраструктура недоступна, сайт может не открываться даже при полностью исправном веб-сервере.
Один из вариантов — использовать DNS-провайдера, независимого от компании, предоставляющей сервер.
Тогда при аварии основного хостинга сохраняется возможность управлять доменными записями.
Например, можно изменить A-запись и направить домен на заранее подготовленный резервный сервер.
Однако обычная смена DNS-записей не гарантирует мгновенное переключение.
Результат зависит от TTL, кеширования, доступности DNS и корректности настроек.
Для более сложных проектов можно использовать балансировщик нагрузки с проверкой состояния серверов.
Он периодически проверяет основной сервер. Если тот становится недоступным, пользовательские запросы могут направляться на резервную инфраструктуру.

Например, Cloudflare Load Balancing позволяет использовать проверки доступности серверов и направлять трафик между подготовленными группами ресурсов.
При этом автоматическое переключение само по себе не решает проблему синхронизации баз данных. Если резервный сервер содержит устаревшую информацию, пользователи могут столкнуться с отсутствующими заказами или другими несоответствиями.
Когда подходит: проектам, которым необходима высокая доступность и которые имеют подготовленную резервную инфраструктуру.
Когда сайт, почта, база данных, DNS и резервные копии находятся у одного поставщика, авария может затронуть все эти элементы одновременно.
Это называется единой точкой отказа.
Разделение компонентов между независимыми сервисами позволяет ограничить последствия сбоя.
Например, корпоративную почту можно обслуживать отдельно от веб-хостинга. Тогда недоступность сайта не обязательно приведёт к остановке переписки с клиентами.
Аналогично можно разделить управление доменом, хранение резервных копий и основное размещение сайта.
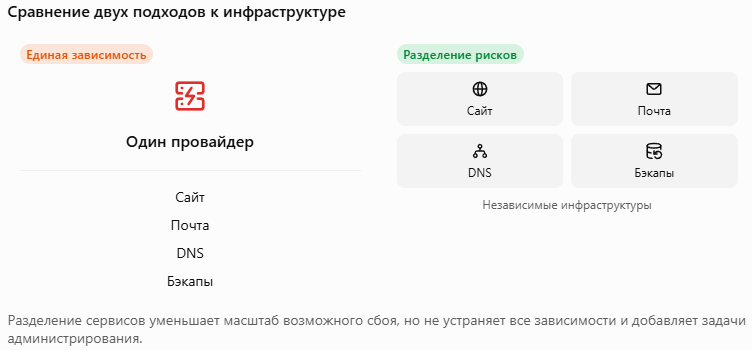
Важно не усложнять архитектуру без необходимости.
Для небольшого сайта дополнительная техническая сложность иногда создаёт больше проблем, чем решает. Каждую систему придётся отдельно контролировать, обновлять и защищать.
Поэтому разделять следует прежде всего те компоненты, одновременная потеря которых критична для бизнеса.
О проблемах с сайтом лучше узнавать от системы мониторинга, а не от клиента, который не смог оформить заказ.
Сервис мониторинга может периодически проверять сайт и отправлять уведомления при возникновении ошибок.
Доступность сайта. Отвечает ли сервер на запросы и возвращает ли корректный HTTP-статус.
Скорость ответа. Нет ли резкого увеличения времени загрузки.
Работу приложения. Отвечают ли критически важные API и внутренние сервисы.
Доступность DNS. Корректно ли разрешается доменное имя.
Состояние SSL-сертификатов. Не истекает ли срок действия сертификата.
Пользовательские сценарии. Работает ли отправка заявки, авторизация или оформление заказа.
Для интернет-магазина проверка главной страницы не гарантирует, что покупатель может завершить заказ.
Поэтому для коммерчески значимых проектов полезно дополнительно проверять реальную последовательность действий пользователя.
Если система мониторинга работает на том же сервере, что и сайт, при серьёзной аварии она тоже может оказаться недоступна.
Лучше использовать внешнюю проверку из нескольких сетей или локаций и независимый канал уведомлений.
Также важно настроить разумные пороги срабатывания. Единичный неудачный запрос не всегда означает полноценный сбой.
Когда подходит: всем коммерческим сайтам. Даже простой внешний мониторинг помогает сократить время обнаружения проблемы.
CDN — сеть доставки контента, которая хранит копии статических ресурсов на распределённых серверах.
Изображения, стили, JavaScript и некоторые HTML-страницы могут загружаться из ближайшего узла CDN, уменьшая нагрузку на основной сервер.
В некоторых конфигурациях кешированные страницы могут оставаться доступными даже при временной недоступности основного хостинга.
Но возможности CDN ограничены.
Например, если интернет-магазин использует динамическую корзину и базу данных, CDN не сможет самостоятельно обработать новый заказ при полном отказе серверной части.
| Задача | Возможности CDN |
|---|---|
| Ускорение загрузки статических файлов | Да |
| Снижение нагрузки на основной сервер | Да |
| Защита от некоторых типов DDoS-атак | При наличии соответствующих функций |
| Показ ранее кешированных страниц при сбое | В некоторых конфигурациях |
| Восстановление утраченной базы данных | Нет |
| Полноценная работа корзины без основного сервера | Не обеспечивается обычным кешированием |
| Автоматическое переключение между серверами | При наличии отдельной настройки балансировки |
Для информационного сайта CDN может существенно повысить устойчивость к отдельным проблемам.
Но для сложного веб-приложения необходима комплексная архитектура.
Даже самая продуманная инфраструктура не принесёт пользы, если во время аварии никто не знает, что делать.
План аварийного восстановления, или Disaster Recovery Plan, описывает порядок действий при серьёзной недоступности сайта.
Он должен отвечать на несколько вопросов:
Это два ключевых показателя для планирования восстановления.
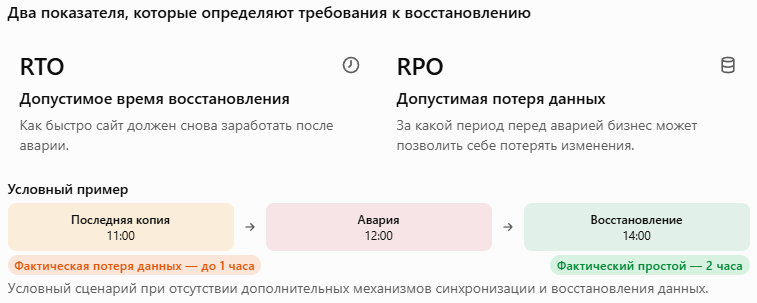
Допустим, компания определила RTO в два часа и RPO в 15 минут.
Это означает, что после серьёзной аварии сайт должен быть восстановлен в пределах двух часов, а потеря данных не должна превышать 15 минут.
Чтобы достичь таких показателей, может потребоваться частое резервное копирование, репликация базы данных и заранее подготовленный сервер.
Однако сами по себе заданные значения ничего не гарантируют. Их достижимость проверяют практическими испытаниями.
AWS Well-Architected отдельно рекомендует тестировать процедуры переключения и восстановления, чтобы подтвердить выполнение RTO и RPO.
Полезный тест выглядит следующим образом.
Специалист разворачивает проект на отдельном сервере, используя доступные резервные копии и документацию.
Затем проверяет:
Если сайт невозможно восстановить из имеющихся копий, проблему лучше обнаружить во время планового теста.
Не каждому бизнесу необходима сложная система из нескольких активных серверов.
Выбор зависит от стоимости простоя, сложности проекта и допустимых расходов на обслуживание.
| Тип проекта | Разумный базовый набор | Что можно добавить |
|---|---|---|
| Сайт-визитка | Внешние бэкапы, мониторинг, доступ к DNS | Холодный резерв |
| Корпоративный сайт | Независимые копии файлов и БД, мониторинг, план восстановления | Подготовленный резервный сервер |
| Интернет-магазин | Частое резервирование БД, внешний мониторинг, тест восстановления | Тёплый резерв и автоматическое переключение |
| B2B-портал | Независимые копии, документированная инфраструктура, проверенные процедуры | Репликация данных и отказоустойчивые сервисы |
| Критически важная платформа | Формальные RTO/RPO, тесты аварий, резервирование компонентов | Мультизональная или мультипровайдерная архитектура |
Рекомендации ориентировочные. Архитектуру необходимо выбирать по реальным требованиям конкретного бизнеса.
Например, корпоративный сайт с небольшим количеством заявок может обходиться без горячего резерва. Но если через него ежедневно проходят дорогостоящие B2B-заказы, допустимое время простоя может быть существенно меньше.
Если сайт недоступен прямо сейчас, важно не тратить время на хаотичные изменения конфигурации.
Действуйте последовательно.
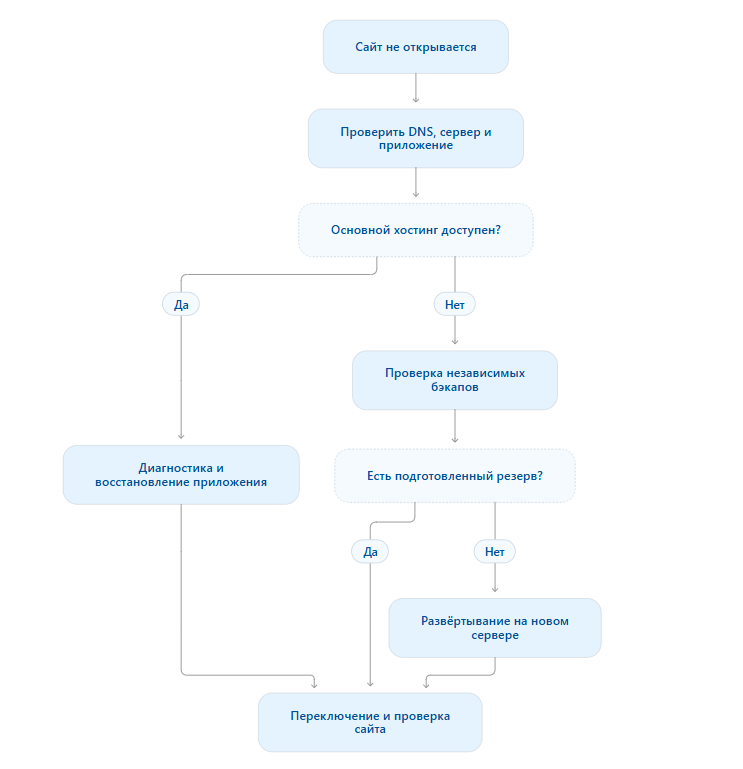
Проверьте ситуацию у провайдера и отдельно протестируйте сайт из нескольких сетей.
Определите масштаб проблемы: недоступен только сайт, конкретный сервер или вся инфраструктура.
Если реклама продолжает вести пользователей на неработающие страницы, временно приостановите соответствующие кампании.
Выясните доступность резервных копий и возможность восстановления на другом сервере.
Если у вас уже есть подготовленный резерв, проверьте актуальность его данных и работоспособность ключевых функций.
Если резерв отсутствует, оцените, можно ли развернуть сайт из доступных копий. При этом следует сохранить имеющиеся данные и не допускать перезаписи единственного экземпляра.
Проверьте не только главную страницу, но и:
Только после функциональной проверки можно считать сайт готовым к полноценной работе.
Для поисковых систем недоступность сайта означает невозможность получить содержимое страниц.
Если робот регулярно сталкивается с серверными ошибками, он может сократить интенсивность обхода. При длительной недоступности возрастает риск проблем с индексированием.
Google прямо указывает, что продолжительные серверные ошибки способны привести к исключению URL из индекса. При сетевых и DNS-ошибках интенсивность обхода также может снижаться.
Если сервер ещё отвечает, но временно не способен обслуживать запросы, можно настроить HTTP-статус 503 Service Unavailable.
Дополнительно допускается заголовок Retry-After, сообщающий предполагаемое время повторного обращения.
Это помогает обозначить временный характер проблемы, хотя не гарантирует сохранения всех поисковых позиций при продолжительном простое.
Не рекомендуется:
noindex из-за временной аварии.После восстановления необходимо проверить сайт в Яндекс.Вебмастере и Google Search Console.
Особое внимание стоит уделить доступности приоритетных страниц, ошибкам 5xx, sitemap.xml, robots.txt, canonical и динамике индексирования.
Если из-за аварии проект переезжает на новый сервер, но сохраняет прежний домен и URL, для поисковых систем это обычно менее существенно, чем изменение всей структуры сайта.
По теме корректных переездов полезно ознакомиться с материалом TRAFF о миграции сайта и сохранении SEO.
Полностью исключить технические аварии нельзя. Однако независимые резервные копии, резервные серверы, мониторинг и автоматическое переключение помогают сократить время простоя и последствия отказа отдельных компонентов.
CDN может продолжить отдавать часть ранее сохранённого контента, если это предусмотрено настройками. Но динамические функции, зависящие от недоступного сервера и базы данных, могут перестать работать.
Зависит от проекта. Для редко обновляемого сайта ежедневная копия может быть приемлемой. Для интернет-магазина с постоянными заказами потеря данных за сутки обычно недопустима. Частоту резервирования необходимо определять с учётом RPO.
Не всегда. Небольшому сайту может быть достаточно независимых резервных копий и понятной процедуры восстановления. Второй сервер оправдан, если стоимость длительного простоя превышает затраты на резервирование.
Да. Для этого используют балансировщики с проверкой состояния серверов и заранее подготовленную резервную инфраструктуру. При этом необходимо отдельно обеспечить актуальность данных и исправность приложения.
Проверки должны быть регулярными, а их периодичность зависит от критичности проекта. Особенно важно проводить тестовое восстановление после существенных изменений инфраструктуры, приложения или процесса резервирования.
Защита сайта от падения хостинга — это не один инструмент, а система мер, которая позволяет сохранить данные и восстановить работу при отказе инфраструктуры.
Небольшому корпоративному сайту в большинстве случаев достаточно качественных независимых резервных копий, внешнего мониторинга и документированного порядка восстановления.
Для интернет-магазинов и сервисов с постоянными транзакциями требования выше. Здесь могут потребоваться резервные серверы, синхронизация данных и автоматическое переключение.
При этом усложнять инфраструктуру без объективной необходимости не стоит. Каждое дополнительное решение увеличивает расходы и требует технического сопровождения.
Главная задача — не создать инфраструктуру, которая никогда не ломается, а обеспечить управляемое восстановление, если сбой всё-таки произошёл.
В TRAFF мы рассматриваем стабильность сайта как часть его развития. Технические проблемы влияют не только на доступность страниц, но и на заявки, рекламные кампании, аналитику и поисковую видимость. Поэтому при технической поддержке сайта важно учитывать всю цепочку работы проекта, от хостинга и баз данных до пользовательских сценариев.
Канал в телеграмм — https://t.me/+-BsUnghNcJ81OGYy
Наш канал на Youtube — https://youtube.com/@traff058
Telegram Паблик — https://t.me/+R2NG4GVGqS4yOTky
Паблик в VK — https://vk.com/traff_agency
Блог на vc.ru — https://vc.ru/u/2452449-studiya-razrabotki-saitov-traff