В ночь с 1 на 2 ноября 2026 года российский хостинг-провайдер Beget столкнулся с масштабной кибератакой. Перестали открываться сайты, возникли проблемы с виртуальными серверами, корпоративной почтой, DNS и панелью управления. Впоследствии провайдер подтвердил, что злоумышленники получили доступ к управляющей инфраструктуре и запустили программы, предназначенные для удаления данных.
Инцидент оказался значительно серьёзнее обычной технической аварии. Пострадала не отдельная группа серверов, а инфраструктура, обеспечивающая работу сразу нескольких сервисов. По официальным данным, часть информации облачной платформы была утрачена, хотя файловые резервные копии сохранились. Поиск уязвимостей и угроз+1
Для владельцев сайтов произошедшее стало напоминанием о важной особенности интернет-инфраструктуры: даже надёжный хостинг не исключает риска серьёзного простоя. Разбираем, что произошло с Beget, какие данные удалось сохранить и как бизнесу действовать после подобных инцидентов.
По информации самого провайдера, приблизительно в 02:00 мск злоумышленники получили доступ к управляющим серверам. Около 02:30 было запущено вредоносное программное обеспечение, предназначенное для уничтожения данных.
Через несколько минут специалисты обнаружили несанкционированный доступ. В 02:55 серверы отключили от сети, чтобы ограничить дальнейшее распространение атаки.
Таким образом, причиной сбоя стало не просто превышение нагрузки или кратковременная недоступность оборудования, а вмешательство в инфраструктуру управления.
2 НОЯБРЯ 2026
3–4 НОЯБРЯ 2026
Восстановление происходило поэтапно. Это объясняет, почему у одних пользователей доступ к сайту мог появиться раньше, чем у других, а работа домена не гарантировала работоспособности самого проекта.
Последствия атаки зависели от используемых продуктов провайдера.
| Сервис | Что произошло | Последствия для клиентов |
|---|---|---|
| Виртуальный хостинг | Массовая недоступность, поэтапное восстановление | Не открывались сайты |
| VPS/VDS | Утрата данных облачной инфраструктуры | Требовалось восстановление серверов и приложений |
| DNS | Нарушение работы, восстановление NS-серверов 2 ноября | Домены могли перестать разрешаться |
| Электронная почта | Перебои, затем постепенное восстановление | Проблемы с отправкой и получением сообщений |
| S3 и Kubernetes | Утрата данных облачной инфраструктуры по заявлению Beget | Риски для файлов, контейнерных приложений и зависимых сервисов |
| CDN и IP-настройки | Провайдер сообщил об утрате конфигураций | Необходимость перенастройки инфраструктуры |
| Панель управления | Ограниченная доступность | Затруднённое управление услугами и восстановлением |
Данные основаны на официальных сообщениях Beget. Состояние отдельных сервисов после публикации может измениться.

Для открытия сайта недостаточно работоспособности его веб-сервера.
Сначала браузер должен определить IP-адрес по доменному имени. За этот процесс отвечают DNS-серверы.
Если компания использует DNS Beget, проблемы с ними могут сделать сайт недоступным даже тогда, когда сам сайт физически размещён у другого провайдера.
При этом восстановление DNS решает только проблему определения адреса. Если сервер сайта, база данных или приложение не работают, посетитель всё равно увидит ошибку.
Поэтому при диагностике необходимо проверять отдельно DNS, сетевую доступность, веб-сервер и само приложение.
Ключевым обстоятельством стал доступ злоумышленников к управляющему контуру.
Управляющий контур — это совокупность инструментов и серверов, с помощью которых администраторы управляют виртуальными машинами, сетями, хранилищами и другими компонентами платформы.
Обычный взлом сайта может ограничиваться одним приложением или учётной записью. Компрометация централизованного управления потенциально опаснее, поскольку позволяет воздействовать сразу на большое количество ресурсов.
Как управляющий контур влияет на работу сервисов
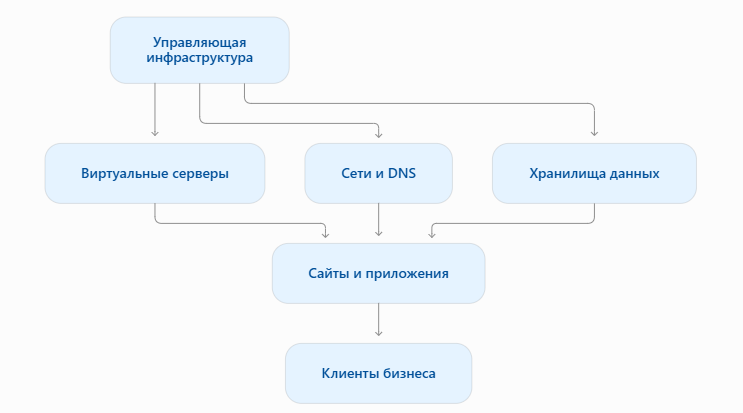
Упрощённая схема зависимости сервисов от управляющей инфраструктуры. Она иллюстрирует общий технический принцип, а не точную архитектуру Beget.
Факт получения доступа к управляющему контуру подтверждён. Однако точный первоначальный способ проникновения публично не раскрыт.
Пока нельзя достоверно утверждать, что причиной стала конкретная программная уязвимость, ошибочная настройка, компрометация учётных данных или иной механизм.
Тем не менее произошедшее позволяет выделить несколько важных вопросов к архитектуре безопасности крупных платформ.
Разграничение доступа. Насколько ограничены полномочия отдельных учётных записей и административных систем? Получение доступа к одному компоненту не должно автоматически означать контроль над всей инфраструктурой.
Сегментация. Могут ли проблемы одного технологического сегмента распространяться на остальные?
Защита резервных копий. Доступны ли злоумышленнику те же механизмы управления, через которые создаются и удаляются бэкапы?
Восстановление. Сколько независимых компонентов требуется вернуть в работу, прежде чем пользователи снова получат доступ к своим данным?
Эти вопросы применимы к любому крупному хостинг-провайдеру. Они не являются доказательством конкретных нарушений со стороны Beget.
Один из самых важных вопросов после кибератаки — можно ли восстановить сайт.
По заявлениям Beget, файловые резервные копии виртуального хостинга и облачной инфраструктуры сохранились. При этом провайдер сообщил об утрате бинарных бэкапов VPS и данных облачных сервисов.
Предварительная оценка провайдера предполагала возможность восстановления почти всех сайтов, размещённых на виртуальном хостинге.
Однако возможность восстановления и фактическая доступность сайта — разные вещи.
Даже при наличии копий нужно проверить серверы, подготовить рабочее окружение, восстановить файлы и базы данных, настроить необходимые сервисы.
Beget сообщил о необходимости ручной проверки более тысячи серверов. Поэтому восстановление требовало значительного времени.
Для владельцев VPS ситуация оказалась сложнее.
Бинарная резервная копия виртуальной машины обычно позволяет восстанавливать систему как единый образ: с установленным программным обеспечением, конфигурацией и сохранённым состоянием диска.
Файловый бэкап содержит отдельные файлы и каталоги. Он может помочь вернуть данные, но не обязательно позволяет автоматически восстановить весь сервер.
Это особенно важно для проектов, работающих на Docker, Kubernetes, собственных API, нестандартных конфигурациях баз данных и сложных интеграциях.
Рассмотрим условный пример.
Компания использует VPS, на котором размещены:
Если сохранился только исходный код приложения, этого недостаточно.
Для полноценного восстановления могут понадобиться актуальные данные PostgreSQL, переменные окружения, ключи доступа, конфигурационные файлы и описание инфраструктуры.
Если база данных не попала в резервную копию либо копия не позволяет восстановить согласованное состояние базы, сайт может открыться, но информация о заказах, клиентах или заявках будет отсутствовать.
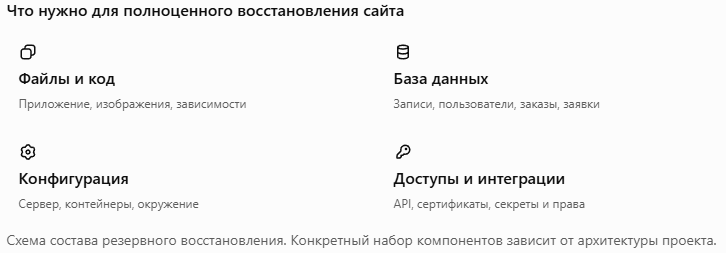
Поэтому вопрос «Есть ли бэкап?» недостаточно точен. Правильнее выяснить, какие именно данные сохранены, на какую дату и время, в каком формате и проверялась ли возможность их восстановления.
Последовательность действий зависит от состояния хостинга, доступности резервных копий и архитектуры проекта.
Проверьте:
Не стоит считать сайт восстановленным только потому, что главная страница начала открываться.
Установите, какие копии доступны:
Репозиторий с кодом — это не полноценная резервная копия работающего сайта. Он может не содержать базу данных, пользовательские файлы и конфигурацию.
Если доступных копий нет, не запускайте восстановление поверх единственного сохранившегося экземпляра данных без предварительного сохранения его состояния.
Перенос на другой сервер может быть разумным решением, если есть актуальные копии и понятный порядок развёртывания.
Но покупка нового хостинга сама по себе проблему не решит.
Если база данных осталась на недоступном VPS, а её копии нет, переезд позволит развернуть приложение, но не вернёт утраченные записи.
Перед переносом необходимо определить, какие данные есть в наличии и какие компоненты потребуется создавать заново.
Beget предоставил отдельный интерфейс управления доменами:
Через него можно изменять DNS-записи для доменов, обслуживаемых DNS-серверами Beget. Провайдер также сообщил о расширении доступности инструмента на международные доменные зоны.
Если сайт восстановлен у другого провайдера, можно направить домен на новый сервер.
Перед изменением записей сохраните текущие значения A, AAAA, MX, TXT и других используемых записей. Проверьте, как смена повлияет на почту и сторонние сервисы.
Обновление DNS может занимать время из-за кеширования записей.
После компрометации инфраструктуры необходимо оценить, какие секреты могли храниться на затронутых серверах.
В первую очередь:
Сам Beget рекомендовал сменить потенциально затронутые учётные данные.
Проверка должна выполняться до полноценного возврата приложения в эксплуатацию, чтобы исключить использование скомпрометированных доступов.
Недостаточно убедиться, что сервер возвращает ответ 200 OK.
Необходимо протестировать реальные пользовательские сценарии: отправку заявки, оформление заказа, вход в личный кабинет, отправку почтового уведомления и работу интеграций.
Особое внимание уделите данным, которые могли измениться непосредственно перед сбоем.
Последствия простоя выходят за рамки технической доступности.
Если сайт не работает, бизнес может терять заявки, продажи и возможность взаимодействовать с действующими клиентами.
Одновременно возникают риски для поискового продвижения.
Поисковые роботы периодически обращаются к страницам, чтобы проверять их содержимое и доступность.
Если сервер долго не отвечает либо регулярно возвращает ошибки, робот не может нормально обходить сайт.
Для Google временные ошибки сервера могут приводить к снижению частоты обхода. При длительных проблемах URL могут постепенно выпадать из индекса. В Яндексе также необходимо контролировать ошибки обхода и доступность страниц через Вебмастер.
Но кратковременный сбой не означает автоматическую потерю всех позиций.
Последствия зависят от продолжительности простоя, характера ошибок, частоты обхода и состояния сайта после восстановления.
Нет, временная авария сама по себе не является причиной устанавливать noindex для всех страниц или запрещать обход в robots.txt.
Если сервер работает, но временно не может обслуживать запросы, корректный ответ 503 Service Unavailable может быть полезен для обозначения временной недоступности. По возможности используют и заголовок Retry-After.
Не следует отдавать поисковым системам страницу с текстом «Сайт не работает» и кодом 200 OK вместо полноценного содержимого. Это может создавать дополнительные проблемы с обработкой страниц.
Если сервер полностью недоступен из-за аварии провайдера, настроить ответ 503 без альтернативной инфраструктуры может быть невозможно.
При недоступном сайте продолжать направлять на него оплачиваемый трафик нецелесообразно.
Даже если объявления продолжают показываться, пользователь не сможет ознакомиться с предложением или оставить заявку.
Рекомендуемый порядок действий:
Если простой был длительным, автоматическим стратегиям может потребоваться адаптация после возобновления рекламных кампаний.
После восстановления сайта важно убедиться, что проблема действительно устранена для поисковых роботов.
Проверьте:
Если сайт восстановлен на другом сервере без изменения URL и содержимого, не требуется автоматически отправлять все страницы на переиндексацию.
Сначала нужно проверить, как поисковые системы видят восстановленный ресурс.
Для системной диагностики можно провести технический аудит сайта и отдельно оценить последствия простоя для органического трафика.
Полностью исключить технические аварии и кибератаки невозможно. Но можно существенно уменьшить вероятность полной потери проекта и сократить время восстановления.
Если сайт и все его бэкапы находятся внутри одной инфраструктуры, масштабная авария может сделать недоступным и оригинал, и копии.
Практичный подход — использовать несколько независимых мест хранения.
Например:
Для критически важных данных полезны неизменяемые резервные копии и отдельные учётные данные, которые не позволяют рабочему серверу удалять архивы.
Наличие файлов в резервном хранилище ещё не подтверждает их пригодность.
Периодически необходимо проводить тестовое восстановление в отдельном окружении.
Проверьте, запускается ли приложение, восстанавливается ли база данных и работают ли ключевые пользовательские функции.
Для одного бизнеса несколько часов недоступности сайта могут быть неприятностью. Для другого даже 30 минут означают существенные потери.
Поэтому полезно заранее определить:
RTO (Recovery Time Objective) — целевое время восстановления работы сервиса.
RPO (Recovery Point Objective) — максимально допустимый объём потери данных, выраженный во времени.
Например, если RPO равен одному часу, резервирование должно быть организовано так, чтобы при аварии потеря данных не превышала примерно часа при выполнении заданных условий.
Необязательно переносить каждый сервис к отдельному провайдеру.
Но разумно оценить последствия одновременной недоступности сайта, почты, DNS, базы данных и хранилища резервных копий.
Если все компоненты зависят от одного поставщика, это единая точка отказа на уровне бизнеса.
Мониторинг должен обнаруживать проблемы раньше, чем о них сообщат клиенты.
Проверяйте не только доступность главной страницы, но и:
Желательно, чтобы уведомления о сбое приходили через канал, который не зависит от аварийной инфраструктуры.
Чек-лист готовности сайта к сбою
☐ Есть актуальный бэкап за пределами основного хостинга
☐ Отдельно сохраняются базы данных
☐ Проверено тестовое восстановление
☐ Документирована конфигурация сервера
☐ Есть доступ к управлению доменом и DNS
☐ Настроен независимый мониторинг
☐ Известен порядок действий при аварии
☐ Подготовлены резервные доступы и контакты
Даже выполнение всех пунктов не гарантирует непрерывную работу. Но оно позволяет значительно лучше подготовиться к аварийному восстановлению.
Решение о смене провайдера не должно приниматься только под влиянием одного инцидента.
Следует оценить несколько факторов: качество восстановления, доступность резервных копий, техническую поддержку, прозрачность информирования и способность инфраструктуры соответствовать требованиям конкретного проекта.
Для небольшого информационного сайта достаточно одного надёжного хостинга при наличии независимых резервных копий.
Для интернет-магазина, крупной B2B-платформы или сервиса с постоянными транзакциями требования могут быть существенно выше.
В таких случаях оправданно рассматривать резервную инфраструктуру, независимые DNS, внешнее хранение данных и более сложную архитектуру восстановления.
Главный вопрос заключается не в том, какой провайдер никогда не столкнётся с аварией, а в том, насколько быстро конкретный бизнес сможет восстановить работу после серьёзного сбоя.
Причиной стала кибератака. По официальному заявлению провайдера, злоумышленники получили доступ к управляющей инфраструктуре и запустили вредоносное ПО для удаления данных.
По состоянию на последнее проверенное официальное обновление, восстановление шло поэтапно. Единый подтверждённый срок возвращения всех сервисов к нормальной работе не опубликован.
Во многих случаях да. Возможность восстановления зависит от типа хостинга, наличия резервных копий, сохранности баз данных и конфигурации приложения.
Beget сообщил об утрате данных облачной инфраструктуры, включая VPS, а также бинарных резервных копий виртуальных серверов. При этом сохранились файловые бэкапы VPS. Степень восстановления конкретного проекта зависит от их состава.
Да, длительная недоступность создаёт риск проблем с обходом и индексированием. Однако временный простой не означает гарантированную потерю позиций. После восстановления необходимо проверить техническое состояние сайта и данные поисковых систем.
Только если сайт уже работает на доступном сервере. Смена DNS направляет пользователей на другой адрес, но не восстанавливает файлы, базы данных и приложения.
Сбой Beget в ноябре 2026 года показал, насколько серьёзными могут оказаться последствия компрометации инфраструктуры хостинг-провайдера.
Инцидент затронул сразу несколько сервисов, а восстановление оказалось сложным из-за необходимости проверки серверов и работы с резервными копиями.
Для бизнеса из этой ситуации следуют три важных вывода.
Первый — надёжность хостинга не заменяет независимые резервные копии.
Второй — восстановление сайта требует не только файлов, но и сохранности баз данных, конфигурации и интеграций.
Третий — готовность к аварии необходимо проверять заранее, пока инфраструктура работает нормально.
В TRAFF мы рассматриваем техническую поддержку, разработку и продвижение сайта как связанные процессы. Работоспособность сайта напрямую влияет на привлечение клиентов, аналитику и результаты маркетинга. Поэтому после серьёзного простоя важно не только вернуть сайт в сеть, но и проверить его техническое состояние, формы обратной связи, рекламные кампании и поисковую индексацию.
Канал в телеграмм — https://t.me/+-BsUnghNcJ81OGYy
Наш канал на Youtube — https://youtube.com/@traff058
Telegram Паблик — https://t.me/+R2NG4GVGqS4yOTky
Паблик в VK — https://vk.com/traff_agency
Блог на vc.ru — https://vc.ru/u/2452449-studiya-razrabotki-saitov-traff